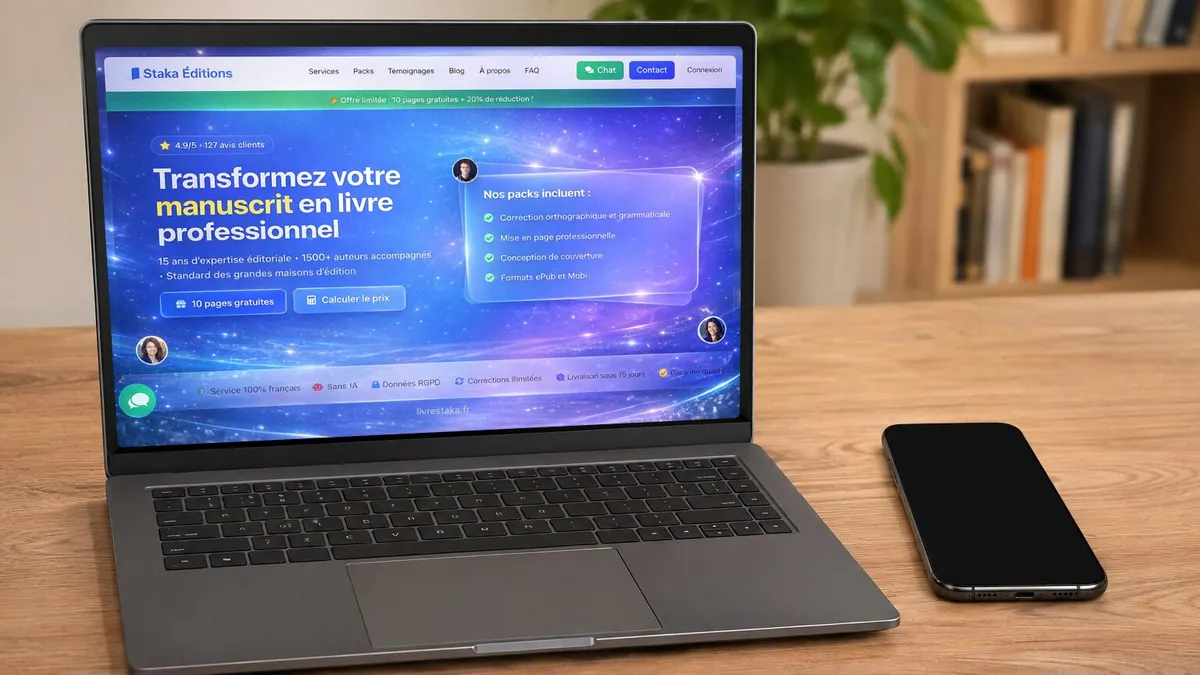
Le besoin
Un auteur doit pouvoir choisir une prestation, envoyer son manuscrit, payer et suivre son projet, puis échanger avec les correcteurs jusqu'à la livraison. L'équipe, de son côté, gère les commandes, les tarifs, les contenus du site et les demandes de support depuis une administration.
Ce que fait la plateforme
- Trois rôles avec des accès distincts : auteur, correcteur et administrateur (authentification par jeton JWT)
- Commande d'une prestation avec ou sans compte, et envoi des fichiers du manuscrit
- Paiement Stripe, facture PDF générée et envoyée par email
- Messagerie entre l'auteur et l'équipe, avec pièces jointes
- Notifications dans l'application et emails automatiques sur les événements du suivi de commande
- Administration : utilisateurs, commandes et statuts, tarifs, FAQ et pages du site
- Données personnelles : export et suppression du compte, et un journal d'audit qui conserve les actions sensibles
L'architecture
Le projet est un monorepo npm : une API Node.js et Express, un frontend React construit avec Vite, et un paquet de types TypeScript partagés entre les deux, pour limiter les écarts entre les données envoyées et celles attendues. Les données vivent dans MySQL 8, décrites par quinze modèles Prisma. L'application tourne dans Docker derrière Nginx, sur un VPS OVH.
Trois décisions techniques
1. Commander sans créer de compte d'abord
Pour ne pas perdre un auteur au moment de payer, une commande peut se passer sans
compte. Ses informations sont gardées dans une commande en attente (une table dédiée,
PendingCommande) avant le paiement. Quand Stripe confirme le paiement, le
serveur crée le compte de l'auteur, en attente d'activation, puis la vraie commande.
Un auteur déjà connecté suit le parcours classique.
2. Un compte Stripe, plusieurs sites
Le compte Stripe du client sert plusieurs sites, et Stripe envoie donc au serveur les notifications de paiement (webhooks) de tous ces sites. Le serveur vérifie d'abord la signature de chaque notification, puis lit la source du paiement enregistrée dans ses métadonnées. Pour un paiement venu d'un autre site, il accuse réception sans rien traiter (réponse 200), ce qui évite que Stripe le renvoie en boucle. Ce filtrage a été ajouté en production en août 2025.
- Stripe envoie au serveur les notifications de paiement de tous les sites qui partagent le compte.
- Le serveur vérifie d'abord la signature : une notification qui ne vient pas de Stripe est refusée.
- Il lit ensuite la source du paiement dans ses métadonnées. Un paiement d'un autre site est ignoré, avec une réponse 200 pour que Stripe ne le renvoie pas.
- Pour un paiement de livrestaka.fr, la commande en attente devient un compte, à activer par l'auteur, et une commande payée.
3. Des notifications découplées des contrôleurs
Pour les notifications, les contrôleurs émettent un événement sur un bus interne (un
EventEmitter de Node.js), et des écouteurs se chargent des notifications
et des emails, envoyés depuis une file asynchrone. Pour un événement déjà émis, une
nouvelle notification s'ajoute en écrivant un écouteur, sans modifier le contrôleur.
Un changement d'architecture en cours de route
Les fichiers des manuscrits étaient d'abord stockés sur AWS S3. En juillet 2025, je les ai migrés vers un stockage sur le VPS qui héberge l'application, pour ne plus dépendre d'un service cloud externe.
Tests et déploiement
Le backend a des tests Vitest et le frontend quelques tests unitaires. Le dépôt contient aussi des scénarios Cypress de bout en bout pour la connexion et les rôles, l'administration, le paiement, la messagerie et l'envoi de fichiers. GitHub Actions sépare les tests unitaires des tests d'intégration. Un script de déploiement applique les migrations Prisma et redémarre les conteneurs, et le certificat SSL se renouvelle automatiquement.
Ce que j'en retiens
Au-delà du code, j'ai mené ce projet en direct avec le client, de la compréhension de son besoin jusqu'à la mise en production, avec des échanges réguliers tout au long du développement.